
Actualizado en septiembre de 2026: corregí de dónde salen los embeddings de entidades geográficas, dónde busca el panel Find Similar (solo en la vista del mapa) y cuántas búsquedas muestra la demo. Los 107 resultados de la búsqueda de carros ahora se cuentan como parches de la grilla, y el bloque de vectores ya no trae valores de ejemplo. También sumé las licencias que exige la herramienta y dos novedades de Esri posteriores a mayo, DINOv3 y los embeddings geodemográficos en beta.
Durante años, hacer analítica avanzada sobre datos geoespaciales tuvo un techo invisible. Si no podías cuantificar bien algo, no podías analizarlo. Querías saber qué predios se parecen entre sí en una ciudad, o qué tramos de una red tienen un comportamiento atípico, o encontrar zonas urbanas con un patrón parecido al de otra ya intervenida. Y la respuesta casi siempre era la misma: entrenar un modelo dedicado para esa pregunta específica. Eso implicaba etiquetar datos, conseguir GPU y dedicarle semanas de trabajo a un modelo que después no servía para nada más.
Los embeddings rompen ese techo porque cambian la manera de representar la información. Cuando un parche de ortofoto, una ubicación o un texto ya está convertido en vector, preguntas que antes costaban un proyecto entero caben en una consulta.
En este post entro al detalle: qué es un embedding, qué es un modelo fundacional, cómo trabajan juntos en el video que comparto más adelante y qué puedes hacer con ellos dentro de ArcGIS Pro 3.7. Lo escribí pensando en analistas y profesionales GIS que, además de verlo funcionar, quieren entender por qué funciona.
1. ¿Qué es un embedding?
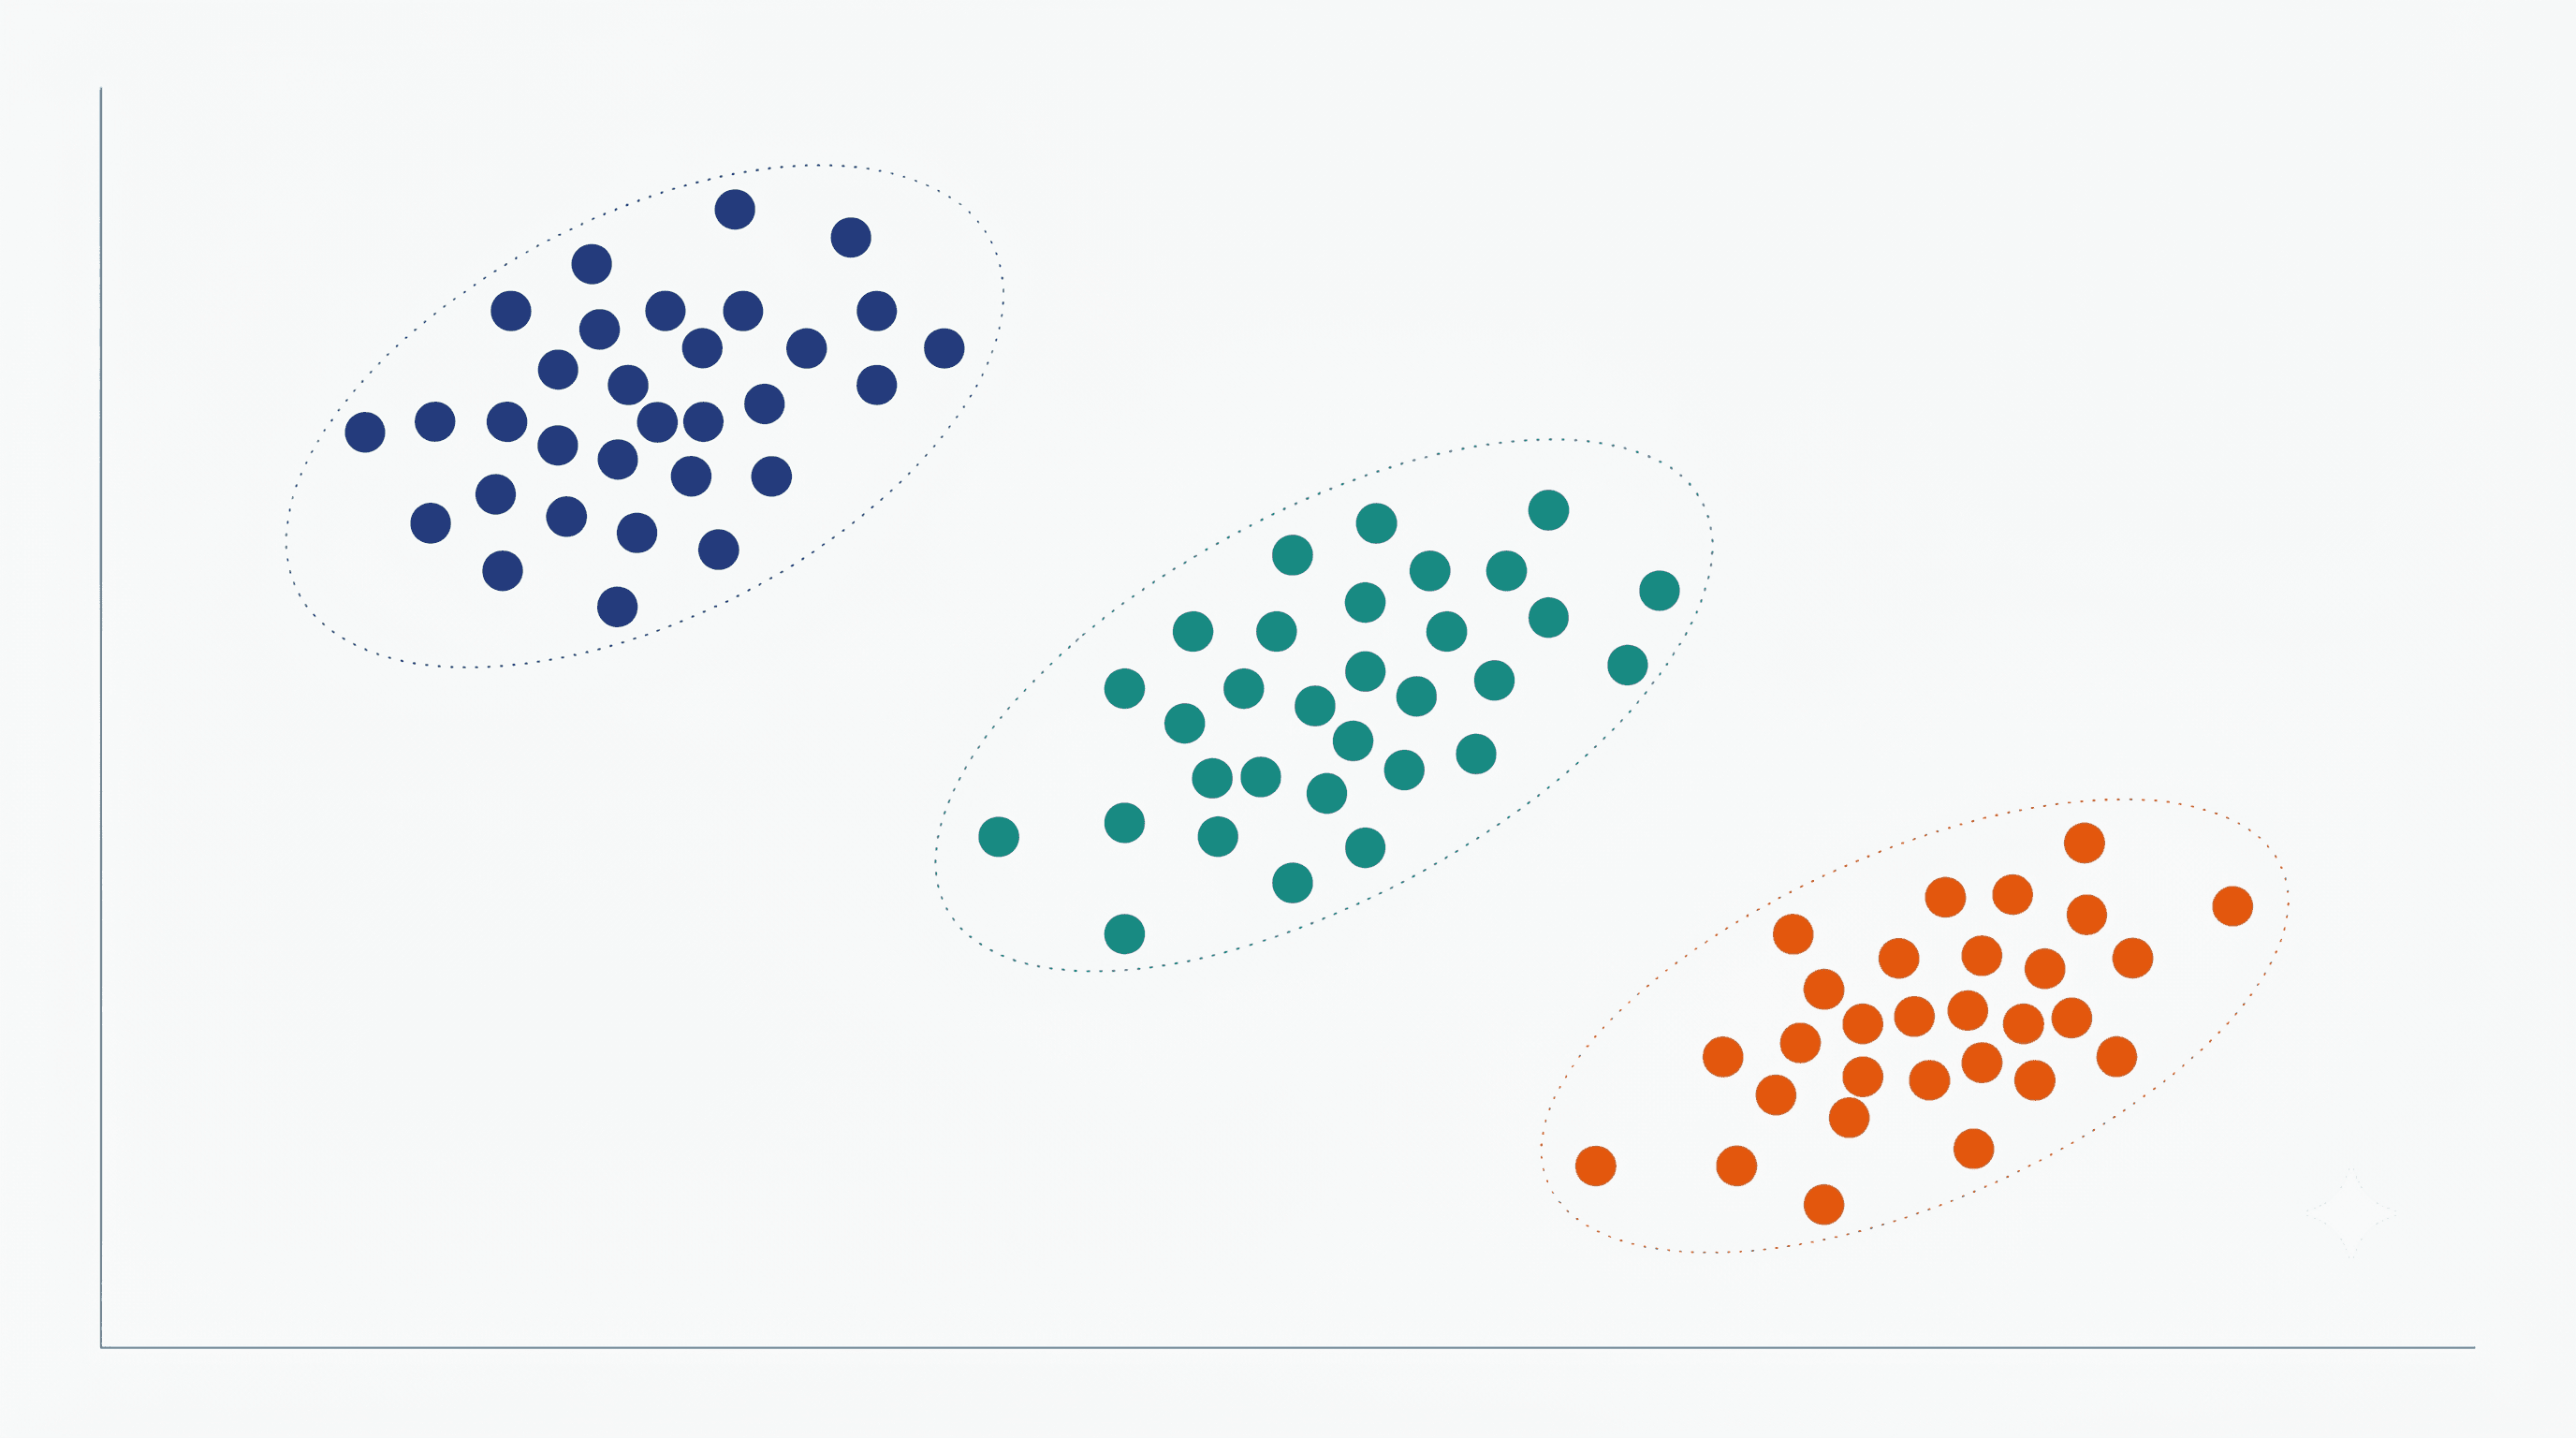
Un embedding es un vector de números que representa algo (una imagen, un predio, un texto, un nodo de una red) como un punto en un espacio matemático de muchas dimensiones.
La idea de fondo es esta: ese espacio se construye de tal forma que la cercanía geométrica entre dos puntos significa parecido en el mundo real. Dos imágenes visualmente similares quedan cerca. Dos predios con perfil parecido quedan cerca. Dos denuncias ciudadanas que describen el mismo problema en palabras distintas también quedan cerca.
La distancia es la información.
Un ejemplo concreto. Si pasas tres parches de una ortofoto por un modelo de embeddings, cada uno sale convertido en un vector de cientos o miles de valores. Lo que cuenta es dónde queda cada vector frente a los otros:
Carro rojo en parqueadero  →  vector A
Carro azul en calle        →  vector B, cerca de A
Techo de teja              →  vector C, lejos de A y de B
Uno de los carros es rojo y está en un parqueadero; el otro es azul y está en una calle. Sus vectores quedan cerca. El del techo va por otro lado. El modelo aprendió a capturar la estructura visual que hace que dos objetos sean del mismo tipo, y a ignorar lo accesorio.
Cuando mides cuán cerca están dos embeddings (normalmente con distancia coseno o euclidiana), estás midiendo cuán parecidos son los originales. Ese es el truco completo.
 Los dos carros salen con vectores casi iguales; el techo, con uno muy distinto.
Una analogía útil
Un embedding es a una imagen lo que las coordenadas son a un lugar. Una ciudad no es un par de números, pero asignarle latitud y longitud permite calcular distancias, encontrar lo más cercano y agrupar zonas. Las coordenadas son apenas una representación de la ciudad, una que permite analizarla.
Los embeddings hacen lo mismo, pero en lugar de dos dimensiones geográficas son cientos de dimensiones semánticas. Y en lugar de capturar dónde está algo, capturan qué es.
2. ¿Quién aprende a generar esos vectores? Los modelos fundacionales
Que un vector capture el parecido entre dos imágenes, dos ubicaciones o dos textos depende del modelo que lo genera. Ese es el segundo concepto de este post: los modelos fundacionales.
Un modelo fundacional es un modelo de deep learning entrenado a gran escala (cientos de millones de ejemplos, muchas veces miles de millones) sin una tarea específica en mente. Durante ese entrenamiento nadie le enseña a reconocer carros ni a clasificar predios: aprende a representar la estructura del mundo dentro de un dominio (imágenes, texto, datos tabulares).
Puestos lado a lado, se ve la diferencia:
Modelos supervisados tradicionales (lo que veníamos haciendo):
- Una tarea por modelo.
- Requieren etiquetado manual masivo.
- El conocimiento queda encerrado en una pregunta específica.
- Cambiar la pregunta significa volver a entrenar.
Modelos fundacionales:
- Una representación general, reutilizable.
- Entrenamiento self-supervised (el modelo se inventa sus propias tareas con datos no etiquetados).
- El conocimiento queda en una representación que sirve para muchas preguntas.
- Cambiar la pregunta es cambiar la consulta sobre el espacio; el modelo queda igual.
El modelo que uso en el video es DINOv2, publicado por Meta AI Research. Es un modelo fundacional para imágenes, entrenado con 142 millones de imágenes sin etiquetar mediante autodestilación (self-distillation). Nadie le enseñó qué es un carro, un árbol o un techo, y aun así sabe representar imágenes.
Y es de código abierto (Apache 2.0): corre en tu equipo, sin enviar nada a la nube. Para una entidad de gobierno, de defensa, de banca o de infraestructura crítica, eso significa que las imágenes no tienen que salir de su red.
 Con el enfoque supervisado, cada pregunta pide su propio modelo. Con un modelo fundacional, una sola representación responde varias.
3. El video: cómo se ve esto dentro de ArcGIS Pro 3.7
ArcGIS Pro 3.7 incorporó a la caja de herramientas GeoAI un conjunto de herramientas (toolset) llamado Embeddings Based Analysis, que reúne cuatro: Generate Embeddings Using AI Models, Find Similar Features Using Embeddings, Merge Embeddings y Extract Embeddings To Fields. En el video aparecen las dos primeras.
Demo sin audio. Primero busco carros y después árboles.
El flujo del video es simple a propósito.
Paso 1: generar los embeddings
Le paso a la herramienta Generate Embeddings Using AI Models una ortofoto de alta resolución, capturada con dron sobre un barrio de Bogotá. Como modelo uso DINOv2, empaquetado en un .dlpk, el formato de paquete de modelos de deep learning de Esri. La herramienta divide la ortofoto en una grilla de parches y, para cada uno, calcula un vector de embedding con el modelo.
El resultado es una clase de entidad (feature class) donde cada entidad representa un parche de la imagen original y guarda su vector de embedding en un campo binario.
En mi instalación local, con un recorte pequeño, este paso tardó unos 10 segundos. Es el único paso costoso del flujo, y se hace una sola vez. Todo lo que viene después consulta esa representación; el modelo no se vuelve a tocar.
Paso 2: hacer preguntas sobre el espacio
Con la capa de embeddings generada, abro el panel Find Similar. Elijo uno o dos parches como referencia, y la herramienta calcula la similitud entre el embedding promedio de mis referencias y el de cada parche que está en la vista del mapa. Los más parecidos quedan resaltados.
En el video hago dos búsquedas seguidas:
- Carro como referencia. El sistema resalta 107 parches de la grilla.
- Árbol como referencia. Marca la vegetación.
Mismo modelo. Misma capa de embeddings generada en el paso 1. Dos preguntas distintas, y ninguna estaba anticipada en el entrenamiento del modelo.
Técnicamente, el panel compara el embedding promedio de las referencias con el de cada parche visible mediante similitud coseno y conserva los que alcanzan un umbral. El trabajo pesado quedó en el paso 1, y la consulta es una comparación de vectores.
 Resultado de la búsqueda con un árbol como referencia: cada celda verde es un parche que el modelo encontró parecido.
Sobre el umbral
Find Similar expone un umbral (threshold; en mi caso, 0.50): la similitud coseno mínima que tiene que alcanzar un parche frente a la referencia para quedar resaltado. Subirlo devuelve menos parches y más precisos; bajarlo devuelve más, con más falsos positivos. Es la perilla de la consulta, y la ajustas mirando los resultados, sin tocar el modelo. Hay una decisión anterior, al generar los embeddings: el tamaño de celda (Grid Size) fija cuánto terreno resume cada vector, y con eso qué tan pequeño puede ser lo que buscas.
4. Las cuatro puertas que abre el espacio vectorial
Una vez tu información está representada en un espacio de embeddings, hay cuatro familias de análisis que se vuelven baratas. Las cuatro se reducen a operaciones geométricas sobre el espacio.
Búsqueda por similitud
Lo que muestra el video. Dado un punto de referencia, encontrar sus vecinos más cercanos. En la práctica es una búsqueda de vecinos más cercanos (nearest neighbor search) con distancia coseno o euclidiana. Find Similar usa similitud coseno con un umbral mínimo.
Aplicaciones GIS: detección automática de objetos parecidos en imágenes, búsqueda de predios parecidos a uno de referencia, identificación de expedientes catastrales con patrones recurrentes, recuperación de documentos territoriales por contenido.
Agrupamiento (clustering)
Encontrar grupos naturales de puntos en el espacio. Algoritmos clásicos como k-means, DBSCAN o HDBSCAN aplicados directamente sobre los embeddings.
Aplicaciones GIS: segmentación de zonas urbanas con patrón similar, tipificación automática de cubiertas a partir de imagen, agrupamiento de denuncias ciudadanas por tema sin definir las categorías a priori.
Detección de anomalías
Identificar puntos que están lejos de cualquier cúmulo en el espacio. Distancia al vecino más cercano, métodos de densidad, isolation forest sobre los embeddings.
Aplicaciones GIS: tramos de red con comportamiento atípico, parcelas con declaración inconsistente con su entorno, infraestructuras dañadas tras un evento climático, construcciones que no encajan con el patrón del barrio.
Recomendación
Dado un conjunto de predios, capas o documentos que ya le interesan a alguien, sugerir otros parecidos. Es la base de los sistemas de recomendación por contenido.
Aplicaciones GIS: "predios candidatos para inspección dado este patrón", "zonas con perfil similar a esta intervención exitosa", sugerencia de capas relevantes en un portal a partir del contenido que ya consume un usuario.
 Las cuatro familias de análisis se apoyan en medir distancias dentro del mismo espacio.
5. También funciona con ubicaciones y con texto
El video muestra el caso visual porque es el más fácil de ver. Pero Generate Embeddings Using AI Models también trabaja con ubicaciones y con texto, y admite modelos multimodales que combinan imagen o contexto espacial con texto:
- Imágenes (rásteres), el caso del video, con modelos como DINOv2.
- Entidades geográficas (features): predios, polígonos, puntos. Según la documentación de Esri, el embedding sale de la geometría, es decir, representa la ubicación y su contexto espacial; de la tabla de atributos, la herramienta solo toma un campo de texto, como en el punto siguiente.
- Atributos de texto: un campo de descripción, narrativa, denuncia u observación de campo, que la herramienta procesa con un modelo de embeddings de texto.
Una vez cualquiera de los tres está convertido en embeddings, vive en un espacio vectorial. Y a un espacio vectorial le da igual qué tipo de dato generó los vectores. Las cuatro puertas se abren igual.
Esto es lo que el video no alcanza a mostrar:
- Un conjunto de predios convertido en embeddings de ubicación permite encontrar predios en entornos parecidos, según lo que el modelo aprendió de cada lugar. Para valorar por comparación, ese vector tendría que entrar junto con los atributos del predio (área, uso, destino) en otro modelo.
- Un corpus de expedientes catastrales o denuncias ciudadanas en texto permite agrupar quejas por lo que describen, aunque las hayan radicado en categorías distintas.
- Una capa de polígonos urbanos puede compararse con una zona ya intervenida para encontrar otras con contexto espacial parecido: zonas candidatas a la misma política.
No todos los tipos de dato están igual de maduros. Los modelos fundacionales de imagen (DINOv2, CLIP) y de texto (familias de BERT, modelos de embeddings de OpenAI o Cohere) ya tienen recorrido. Los modelos fundacionales para datos tabulares geoespaciales son más jóvenes: Esri habló de modelos geodemográficos en el plenario de su Developer & Technology Summit 2026, y otros vienen en camino. La idea funciona igual con cualquier tipo de dato; lo que cambia es cuántos modelos preentrenados (pretrained) hay disponibles.
En junio de 2026 Esri publicó en beta los USA Geodemographic Embeddings, generados con su Geodemographic Foundation Model (GDFM). Cubren solo Estados Unidos contiguo y Alaska, así que por ahora no sirven para predios de la región.
6. ¿Por qué esto importa para el trabajo GIS en LATAM?
Cuando un equipo GIS empieza a trabajar con embeddings, el cambio de fondo se nota en tres frentes.
Primero, la economía del análisis cambia. El costo grande se paga una vez, al generar los embeddings, y muchas preguntas se vuelven baratas sobre la misma representación. Análisis que antes no entraban en el presupuesto ahora caben.
Segundo, lo cualitativo entra al modelo. El carácter de un barrio, el parecido visual entre dos manzanas o entre dos textos, los patrones que no caben en una columna: todo eso pasa de ser "demasiado cualitativo para analizar" a ser una distancia más en el espacio.
Y tercero, la barrera técnica baja. No hay que entrenar ni etiquetar nada. El analista vuelve a estar donde debería estar: haciendo preguntas sobre el territorio.
Para la región esto importa. Mi lectura es que mucho análisis territorial se quedó sin hacer porque los equipos no tenían cómo entrenar modelos propios, y con modelos fundacionales empaquetados esa restricción ya no manda. La barrera que queda es la licencia: en ArcGIS Pro, generar embeddings exige licencia Advanced, y para imágenes además la extensión Image Analyst. DINOv2 es de código abierto, así que puedes montar la misma idea fuera de ArcGIS, con Python y más trabajo.
7. Cómo empezar
Si quieres experimentar con esto en tu instalación, el camino es directo:
- Actualiza a ArcGIS Pro 3.7 y revisa la licencia: la herramienta pide Advanced, más la extensión Image Analyst si trabajas con imágenes. Instala las Deep Learning Libraries de la versión correspondiente; Esri recomienda GPU.
- Descarga el
.dlpkde DINOv2 en Living Atlas o empaqueta tu propia conversión. El de Living Atlas pide una cuenta de organización de ArcGIS y viene con licencia de Esri, distinta de la Apache 2.0 del modelo de Meta. Desde junio de 2026 Esri también publica DINOv3. Si quieres ver qué trae un paquete así por dentro, lo cuento en el post de SAM 3 en Living Atlas. - Prueba
Generate Embeddings Using AI Modelssobre una imagen pequeña primero. Un recorte pequeño basta para tantear tiempos. - Abre el panel
Find Similar, encuadra en el mapa la zona donde quieres buscar y juega con el umbral. Esa es la mejor forma de internalizar la idea de "cercanía = parecido". - Cuando ya domines el caso de imágenes, prueba con una feature class que tenga un campo de texto. Ahí te convences de que el mismo flujo sirve para mucho más que imágenes.
 Esquema con búsquedas de ejemplo: DINOv2 corre una vez sobre la ortofoto y cada búsqueda posterior consulta la misma capa.
Lo que se queda conmigo
Generé la capa del Tintal una vez, en 10 segundos, y después busqué carros y árboles sin volver a correr DINOv2.
Lo que un modelo supervisado tradicional resolvía con semanas de trabajo y un caso de uso específico, un modelo fundacional lo deja accesible como una consulta sobre un espacio. Las preguntas se vuelven intercambiables.
En GeoAI LATAM estamos construyendo comunidad alrededor de la inteligencia artificial aplicada a datos geoespaciales en español, combinando herramientas abiertas (Python, GDAL, QGIS) y comerciales (ArcGIS).
Si llevas años con análisis en el cajón porque "no daba para entrenar un modelo dedicado", esta es la herramienta para volver a ponerlos sobre la mesa.
¿Cuál es el primer análisis que sacarías del cajón?
Sebastián Forero. GeoAI Solutions Engineer y fundador de GeoAI LATAM.
Para profundizar
- DINOv2: Learning Robust Visual Features without Supervision, paper de Meta AI Research (2023) y repositorio de código abierto
- What's new in ArcGIS Pro, Esri: el toolset Embeddings Based Analysis llegó en la 3.7
- An overview of the GeoAI toolbox, documentación de Esri
- Generate Embeddings Using AI Models: parámetros y licencias, documentación de Esri
- USA Geodemographic Embeddings, generados con el Geodemographic Foundation Model de Esri (beta, solo Estados Unidos)