Actualizado en septiembre de 2026: revisé cada cita contra su paper y corregí lo que no decían (el rango r, la elección de SAM-B), separé lo que aplica al SAM original de lo que aplica a SAM 3 y aclaré que el tutorial del final es solo de inferencia.
En 2023 llegó el Segment Anything Model (SAM), de Meta, con una promesa peligrosa: segmentar "lo que sea" con un clic.
Detrás hay un dato clave: Meta lo entrenó con SA-1B, unos 11 millones de imágenes y más de 1.000 millones de máscaras.
Kirillov et al., 2023: Segment Anything
El choque llega cuando lo sacas del mundo "foto natural" y lo tiras al mundo geoespacial: agricultura, catastro, asentamientos, agua con sedimento, laderas, nubes y sombras.
Ahí SAM está fuera de su objetivo: aprendió a segmentar fotos naturales y ahora le das una escena vista desde arriba.
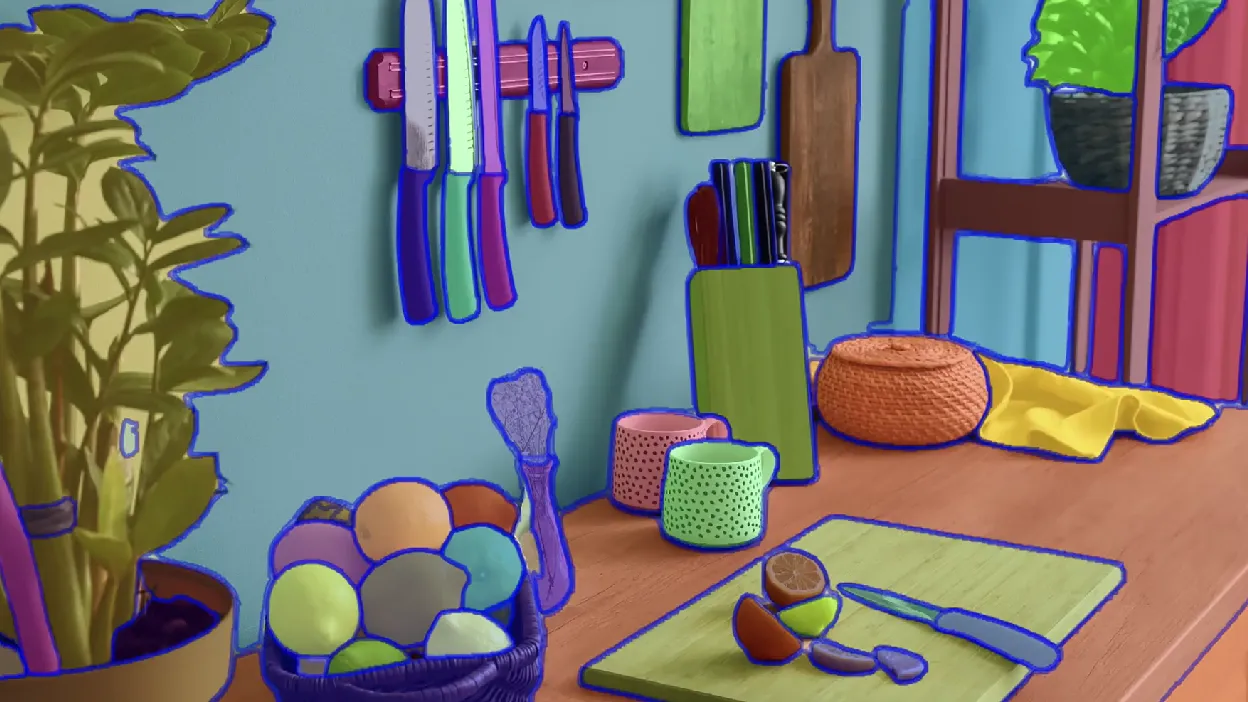
Así se ve la segmentación en su terreno: una foto natural, tomada de frente, donde cada objeto tiene un borde claro.
¿La solución clásica? Full fine-tuning: reentrenar el modelo entero. ¿Y en LATAM? No siempre hay recursos, tiempo ni GPU para hacerlo (y entrenar SAM "desde cero" fue una operación de escala industrial).
Kirillov et al., 2023: Segment Anything
Aquí entra LoRA (Low-Rank Adaptation, adaptación de bajo rango). Sus autores lo midieron en GPT-3: 10.000 veces menos parámetros entrenables y 3 veces menos memoria de GPU que el ajuste completo.
Hu et al., 2021: LoRA
Yo lo leo como la estrategia para que los modelos fundacionales (foundation models) dejen de ser "solo para Big Tech".
El problema: SAM no "piensa" en datos geográficos
Si usas SAM out-of-the-box (tal como viene) en imágenes satelitales, suele fallar por una mezcla de dominio y física. Zhang et al. lo reportan en RSAM-Seg: aplicado directo a la segmentación de imágenes de teledetección, SAM no da resultados satisfactorios, y por eso lo adaptan con adapters, otra técnica de ajuste eficiente distinta de LoRA.
Zhang et al., 2025: RSAM-Seg (Remote Sensing 17(4):590)
Por qué pasa
Geometría cenital (nadir): aplana objetos, cambia bordes y borra señales que en foto natural ayudan.
Espectro y materialidad: SAM nace en RGB; en teledetección muchas separaciones dependen del infrarrojo cercano y de onda corta (NIR, SWIR) o de índices (vegetación, humedad, materiales).
Radiometría y atmósfera: la imagen suele llegar en reflectancia o en 16 bits, con bruma, nubes y sombras; si normalizas mal, el modelo "ve" un mundo roto.
Escala: el mismo "objeto" puede medir 3 px o 300 px según el sensor y su GSD (el tamaño del píxel en el terreno).
La solución: LoRA explicado con pósits
Piensa en SAM como un libro enorme y bien escrito, pero sobre otro planeta.
Full fine-tuning: reescribes capítulos enteros. Sale caro y puedes romper lo que ya funcionaba.
LoRA: dejas el libro intacto y pegas pósits entrenables donde hace falta. El texto base queda congelado; el modelo aprende solo "la corrección".
LoRA aprende una actualización de bajo rango sobre matrices clave (en el paper, las proyecciones de atención) y adapta la red entrenando una fracción de sus parámetros.
Hu et al., 2021: LoRA
Estrategia: menos "setup", más criterio
Meter LoRA es la parte fácil. Lo que decide el resultado es qué enseñar y dónde tocar.
1) ¿Qué SAM estás usando?
El SAM original viene en tres tamaños de encoder: B, L y H. En el paper, H rinde bastante mejor que B y apenas mejor que L; B es el más liviano, y por eso el más barato para iterar.
Kirillov et al., 2023: Segment Anything
SAM 3, el que usa el tutorial del final, se publica como un solo modelo: ahí no hay tamaño que elegir.
Pregunta útil: si no puedes iterar rápido, ¿cómo vas a aprender del error?
2) ¿Dónde pones LoRA?
Hay dos escuelas comunes. Poner LoRA en el image encoder da más capacidad para adaptar las texturas y los bordes del dominio; ponerlo en el decoder sale más barato, pero puede quedarse corto si el dominio está muy lejos.
Pregunta útil: si tu error es "no reconoce la señal", ¿por qué empezarías ajustando el decoder, que es lo último, antes que el encoder, que es lo que "mira"?
3) El rango r
En el paper de LoRA, rangos muy bajos (de 1 a 8) ya daban resultados competitivos en GPT-3, y los autores aclaran que no esperan que eso valga para cualquier tarea.
Hu et al., 2021: LoRA, sección 7.2
Tu dominio queda lejos de GPT-3, así que tómalo como punto de partida: empieza con un r bajo, mide y sube solo si no alcanza.
4) Preproceso: donde se decide casi todo
Dos hechos antes de empezar:
-
El encoder de imagen de SAM recibe 3 canales (RGB) y aprendió con fotos naturales.
-
Si vienes de satélite en reflectancia o en 16 bits, necesitas una transformación coherente antes de entrar a SAM.
Pregunta útil: ¿tu modelo falla por arquitectura, o porque tu pipeline convirtió reflectancia en ruido?
Dónde creo que esto paga en LATAM: asentamientos informales
Los datasets típicos "buscan rectángulos". En autoconstrucción, los bordes son otra historia: ladera, sombras duras, materiales mixtos.
Ahí es donde LoRA debería rendir: cuando le enseñas al modelo tu borde, el que aparece en tu territorio.
La letra chica: lo que LoRA no arregla
Cuello de botella RGB: si tu señal vive en 12 bandas, tienes que decidir cómo traducirla (compuestos, índices, PCA, etc.). SAM recibe tres canales, así que esas 12 bandas tienen que llegarle resumidas en tres.
Normalización mata modelos: una mala escala radiométrica puede arruinarlo todo aunque el fine-tuning sea perfecto.
Objetos diminutos: si el objeto mide cerca de 1 px, el límite lo pone la resolución del sensor, y ningún ajuste del modelo lo mueve.
Una pregunta para la próxima falla
La próxima vez que un modelo falle en tu territorio, prueba esta pregunta antes de pedir más datos o más GPU:
¿Necesito más capacidad, o necesito enseñarle al modelo con pocos ejemplos bien puestos?
¿En qué borde se te quedó corto SAM a ti?
¿Quieres ver SAM 3 antes de ajustarlo?
Tengo un tutorial de SAM 3 aplicado a imágenes aéreas: un Jupyter Notebook paso a paso, en español, que segmenta con prompts de texto. Es solo inferencia, sin LoRA: usa SAM 3 tal como lo publicó Meta. Para correrlo tienes que pedir acceso a los pesos en Hugging Face, y el README recomienda una GPU de 16 GB.
👉 Tutorial SAM 3 para imágenes aéreas: github.com/geoai-latam/SAM3GEO
Siete ejemplos en un solo notebook, desde prompts de texto básicos hasta la inferencia por teselas (tiles). Lo hice con SAM 3; desde marzo de 2026 existe SAM 3.1, que Meta presenta como reemplazo directo.